Nanbeige 팀이 주말 사이 허깅페이스에 Nanbeige4.3-33B를 올렸습니다. 코딩 에이전트나 업무 자동화처럼 여러 단계를 스스로 이어 가는 일에 맞춘 모델이에요. 가중치 파일은 누구나 내려받을 수 있고 라이선스는 상업적 사용을 막지 않는 Apache 2.0입니다.
어떤 모델인가
파라미터는 약 330억 개(33B)입니다. 요즘 많이 비교되는 300억 개 안팎 모델과 같은 체급이죠. 한 번에 최대 524,288토큰(512K)까지 읽습니다. 사전학습만 마친 Base 모델도 따로 올라왔어요.
팀은 이 모델을 시리즈의 '선생 모델'이라고 소개합니다. 큰 모델에서 에이전트 능력을 먼저 키운 뒤 작은 모델로 옮겨 담겠다는 계획인데, 다음 차례로 Nanbeige4.3-3B를 꼽았습니다.
성적은 Nanbeige가 직접 잰 것
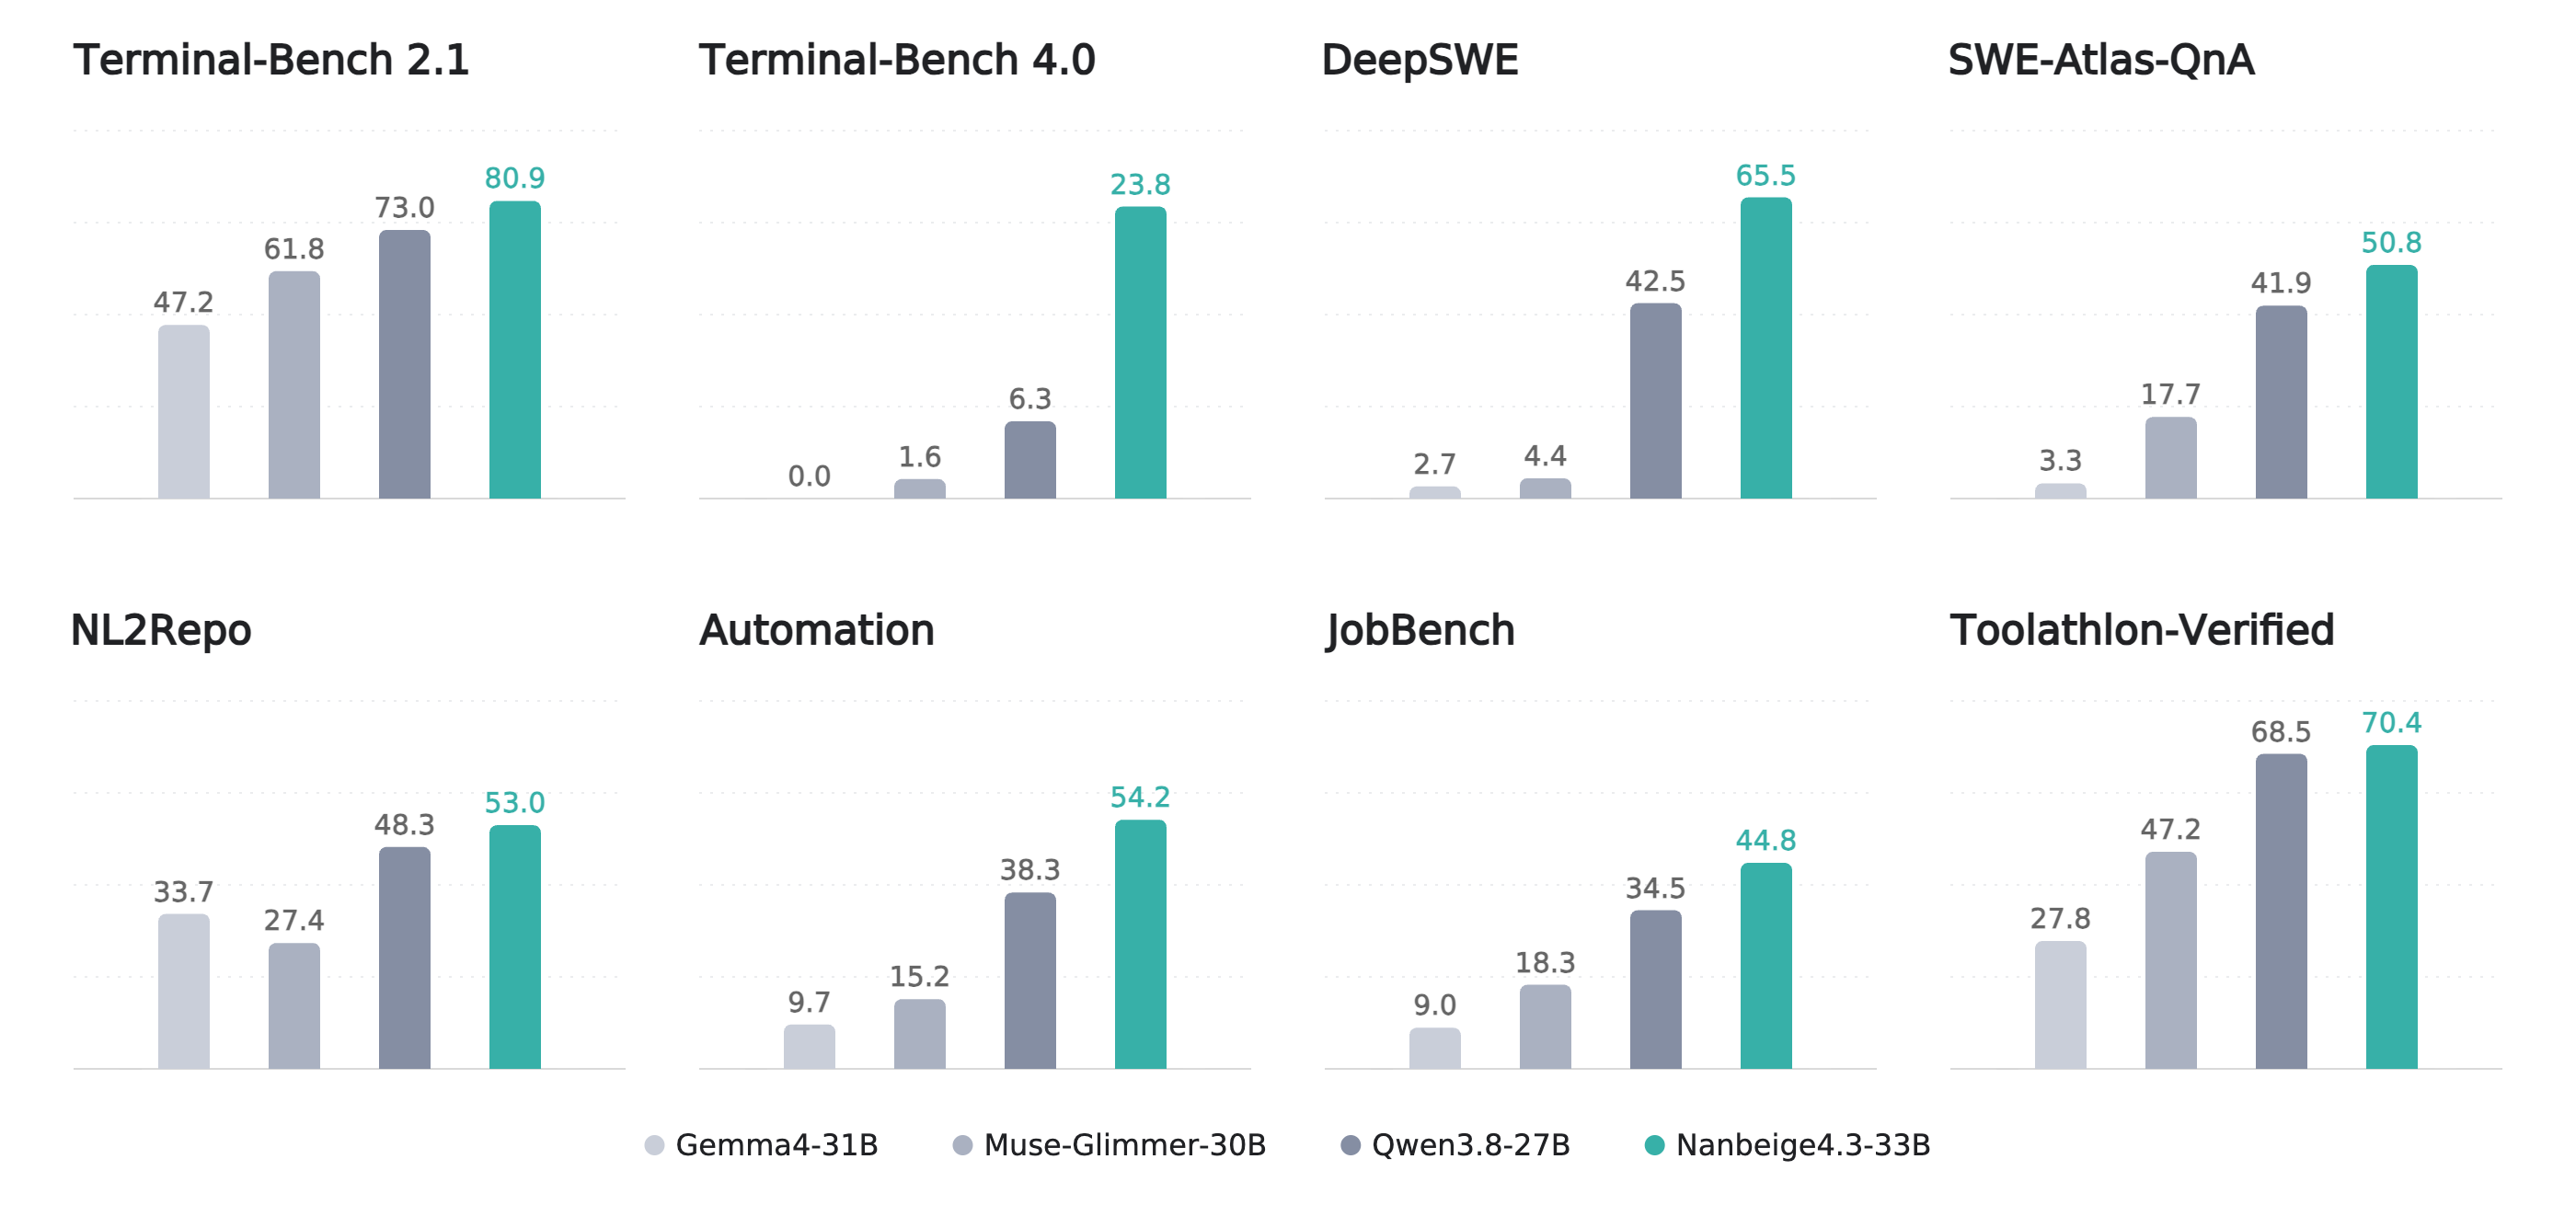
모델 카드에는 Qwen3.8-27B, Muse-Glimmer-30B, Gemma4-31B를 같은 조건에서 돌려 비교한 표가 있습니다. 터미널에서 실제 작업을 시키는 Terminal-Bench 2.1에서는 80.9점으로 Qwen3.8-27B(73.0점)보다 높았어요. DeepSWE에서는 65.5점 대 42.5점으로 차이가 더 벌어졌습니다.
모든 항목에서 앞선 건 아닙니다. SWE-Bench Pro(60.3점 대 61.7점)와 GDPval(84.8점 대 86.4점)은 Qwen3.8-27B가 조금 높았습니다. GPQA Diamond에서 가장 높은 점수는 Gemma4-31B의 91.3점이었고요. 표에 실린 숫자는 모두 Nanbeige 팀이 잰 값이라 다른 곳의 측정이 나오면 함께 봐야 합니다.
직접 돌려 보려면
Transformers, SGLang, vLLM으로 실행할 수 있고 모델 카드에 예시 코드가 있습니다. 공식 SGLang·vLLM 예시는 GPU 4장에 나눠 싣는 설정(--tp-size 4)이에요.
권장 설정도 적혀 있습니다. 도구를 쓰는 에이전트 작업에는 temperature 1.0과 top_p 0.95를, 추론과 일반 대화에는 temperature 0.6을 권합니다. 도구 호출 형식은 xml이 가장 잘 맞는다고 했어요. 여러 턴에 걸쳐 도구를 쓰거나 코드 에이전트로 돌릴 때는 이전 추론을 남겨 두는 preserve_thinking을 켜라고 합니다.
공개 직후 허깅페이스에는 다른 사용자들이 만든 GGUF·MLX 양자화 버전이 여럿 올라왔습니다. 양자화는 모델을 가볍게 줄여 맥이나 개인 그래픽카드에서 돌리기 쉽게 만든 파일입니다. 공식 배포판은 아니에요. 안전장치를 걷어 낸 변형도 섞여 있어서 누가 올렸는지 보고 받는 게 좋습니다.
누구에게 쓸모가 있나
모델 카드에는 앱이나 API 서비스 안내 없이 가중치만 있습니다. 클라우드 API 대신 자기 서버에서 코딩 에이전트를 돌리려는 팀이라면 견줘 볼 후보가 하나 늘었어요. 채팅 앱으로 AI를 쓰는 사람에게는 당장 달라지는 게 없습니다.